세계일주 사이트에 Jev를 붙인 이틀
사진 1,944장에 Jev로 주제를 붙이고, 아무 말이나 치면 지구본이 그 정거장으로 가는 검색을 만든 10월 2일과 3일. 판정선, 결과 0, 사진 먼저, 비용, 로컬에서만 통과한 배포.
세계일주 사이트는 2016년 8월부터 330일 동안 161곳을 돈 여정을 지구본 위에 다시 그린 사이트다. 정거장마다 사진첩이 있고, 사진은 1,900장이 넘는다. 사진을 찾으려면 지구본을 돌려 정거장을 하나씩 열어 봐야 했다.
그래서 사진이 무엇을 담고 있는지로 여정을 다시 보게 하자고 정했다. 물가, 산, 밤, 먹은 것 같은 주제로 사진첩을 묶어 보고, 지구본에 그 주제가 있는 정거장을 켜고, "밤기차"처럼 아무 말이나 치면 지구본이 그 정거장으로 가게 하는 것이다. 사진을 분류하는 데와 말로 찾는 데에 Jev를 썼다. Jev가 어떤 모델인지는 앞 편에 정리했다.
일은 대부분 역할을 나눈 클로드 코드 세션들이 했다. 총괄 세션이 기준 문서를 잡고, 디자이너 세션이 보드를 그리고, 코딩 세션과 조사 세션이 구현하고 측정했다. 아래 숫자도 대부분 그 세션들이 측정한 것이다. 나는 보드를 보고 고르고, 폰으로 써 보고, 이상한 데를 짚었다.
사진 1,944장에 질문 열세 개
먼저 주제를 정했다. 물가, 산, 사막, 눈, 거리, 건축, 먹은 것, 이동, 동물, 햇살, 밤, 물건, 사람. 사람은 내가 더하기로 했고, 밤은 실내도 넣기로 했고, golden hour는 한국어로 "햇살"이라고 부르기로 했다. 주제마다 Jev에게 물을 영어 질문을 writer 세션이 경계 사례까지 붙여 썼다. 14번째 주제인 "나"는 Jev가 아니라 사진 앱의 얼굴 인식으로 붙였다.
앞 편에 쓴 대로 Jev는 사진을 보지 못한다. 그래서 사진마다 도시, 주소, 현지 시각과 사진 앱이 써 둔 설명 문장과 장면 라벨을 글로 넘겼다. 사진 앱의 설명 원문은 분류 재료로만 쓰고, 사이트에는 주제 이름만 나가게 했다.
Jev가 주는 건 주제마다 0에서 1 사이의 확률이다. 몇 이상을 그 주제로 칠지는 내가 정해야 했다. 먼저 사진 50장으로 시험을 돌리고, 주제마다 확률 순으로 사진을 늘어놓은 인화지를 만들어 받았다. 선을 옮기면 그 위의 사진이 켜지고 아래는 흐려진다.
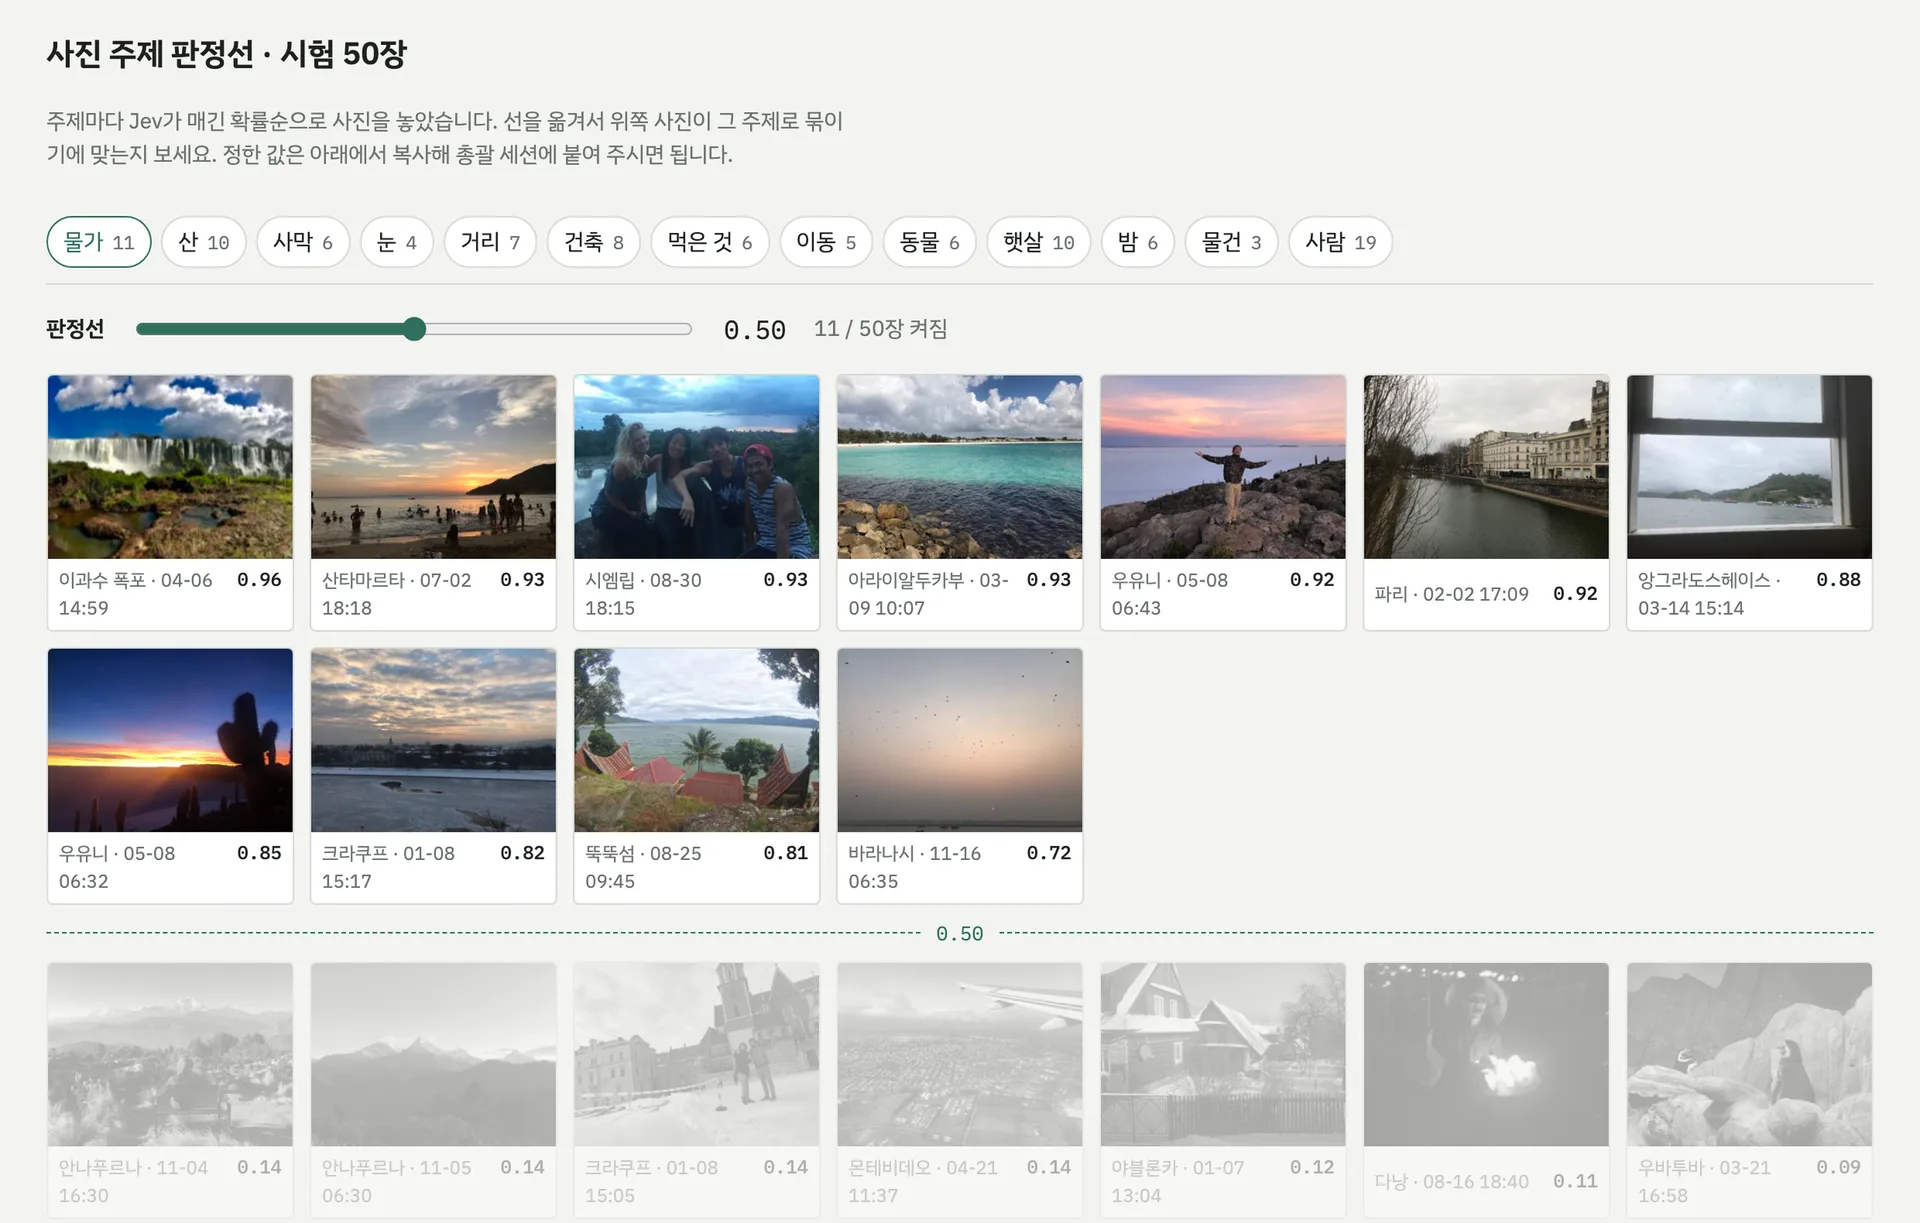
인화지를 넘기면서 선을 정했다. 물가는 0.75, 동물은 0.90, 물건은 0.85로 높게 잡았고, 사막과 건축, 먹은 것, 이동은 0.50에 뒀다. 그다음 남은 1,894장을 한 번에 돌렸다. 에러는 0건이었고, 입력이 1,869,907토큰으로 약 0.08달러가 들었다. 출력 토큰은 받지 않으니 그게 전부다.
사진 1,944장에 대한 답이 원본 그대로 남아 있어서, 주제마다 확률이 어떻게 퍼져 있는지 그대로 그려 볼 수 있다. 점선이 내가 정한 선이고, 슬라이더로 선을 옮기면 몇 장이 그 주제로 묶이는지 바로 바뀐다.
막대 높이는 장수의 제곱근이다. 대부분이 0 근처에 몰려 있어서 그대로 그리면 나머지 막대가 안 보인다.
주제마다 모양이 꽤 다르다. 동물이나 눈, 먹은 것은 0 근처와 1 근처로 깔끔하게 갈라져서 선을 어디에 두든 결과가 크게 안 바뀐다. 사람이나 거리, 햇살, 밤은 가운데에 넓게 퍼져 있어서 선을 조금만 옮겨도 수십 장이 들고 난다. 밤은 0.05 아래로 내려간 사진이 한 장도 없다. 앞 편에 쓴 대로 이 확률을 그 주제일 확률로 읽기보다 사진들을 줄 세우는 순서로 읽는 게 맞는 것 같다.
말로 찾기는 정거장마다 점수를 매긴다
말로 찾기는 구조가 반대다. 사진 분류는 사진 하나를 state로 넣고 주제 열세 개를 물었는데, 말로 찾기는 사용자가 친 말을 state로 넣고, 정거장 141곳을 각각 질문 하나로 만들어 한 요청에 다 묻는다. 정거장마다 "이 정거장이 찾는 것과 얼마나 맞나"를 네 단계 score로 받아 줄을 세우고, 1.5 이상인 곳을 최대 12곳 보여 준다. 정거장 질문에는 그 정거장의 도시, 날짜, 이미 공개된 정거장 이야기, 주제별 사진 수가 들어간다.
같은 요청에 noul 질문을 하나 더 넣었다. "이 말이 여행 사진에서 찾을 만한 것인가." 이게 0.5 아래면 검색이 아닌 말로 보고 거른다. "ㅁㄴㅇㄹ"은 0.13, "펭귄"은 0.44였다.
첫날 밤 처음 프로덕션에 올리자마자 이 API가 500으로 죽었다. 이 이야기는 아래에 따로 쓴다.
찾는 입구가 이스터에그였다
찾는 입구를 어디에 둘지 보드에 여섯 안이 올라왔다. 집 고리 위에 커서가 깜빡이는 안, 아무 글자나 치면 열리는 안, 주제 줄 맨 앞의 빈칸 같은 것들이다.
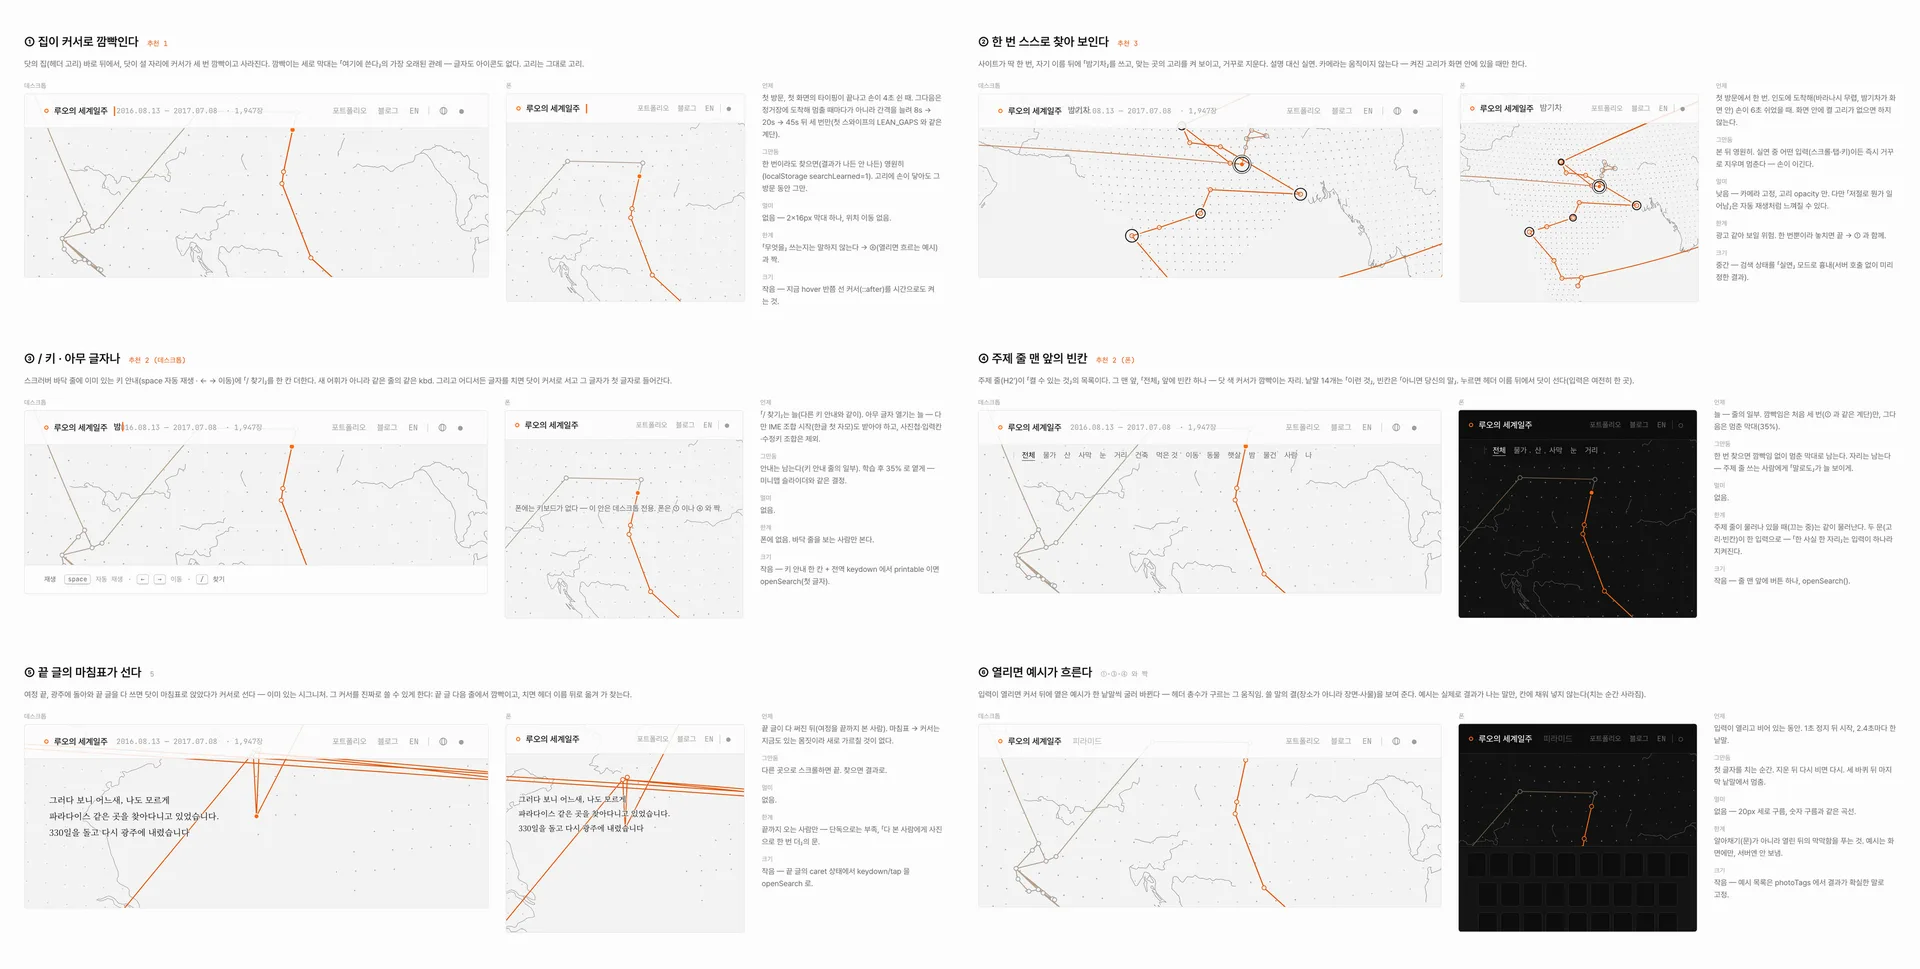
보고 나서 한 말이 "거의 이스터에그수준이네 어케 알고 사용하지? ㅋㅋㅋ"였다. 예시를 보여 주는 건 좋은데 위치와 방식이 별로였다. 검색은 화면 가운데에 크게 띄우고 나머지는 딤 처리해서, AI 검색이라는 느낌이 나게 해 달라고 했다. 시작점이 상상이 안 되는 이스터에그라고.
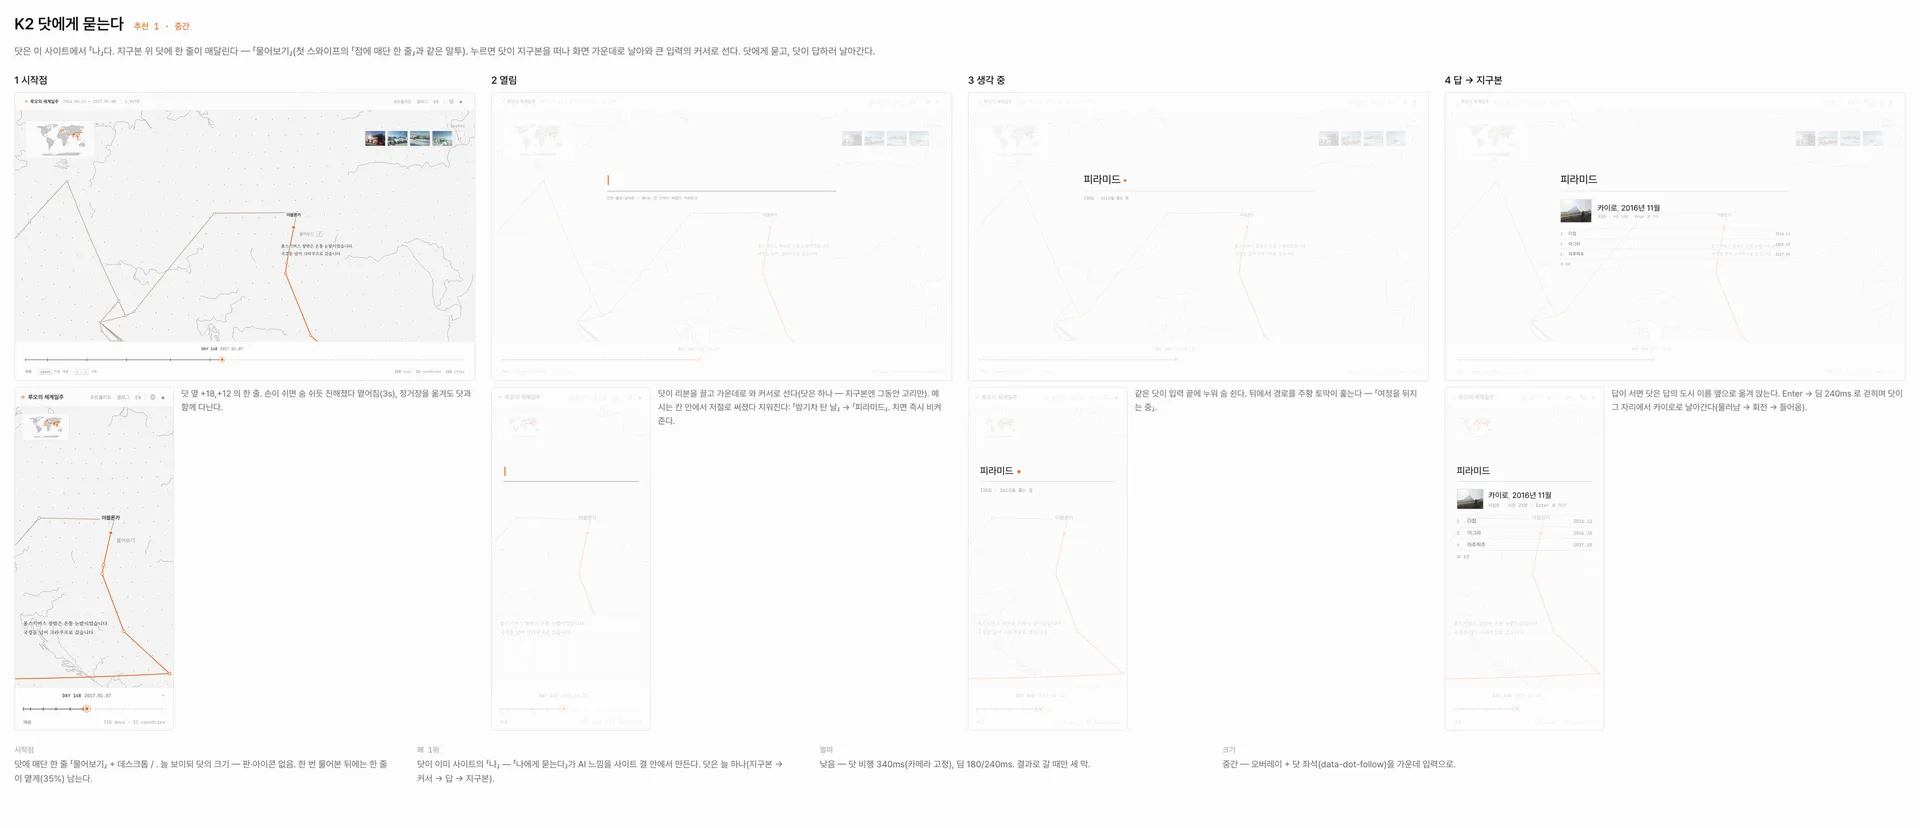
다음 보드에 세 안이 왔고, 그중 K2 "닷에게 묻는다"로 정했다. 이 사이트에는 지금 어디를 보고 있는지 따라다니는 주황 닷이 하나 있는데, 그 닷 옆에 "물어보기"가 달려 있다가 누르면 닷이 화면 가운데로 날아가 큰 입력창의 커서가 된다.
결과가 자꾸 0으로 나왔다
붙이고 나서 써 보니 "개", "배고플때", "사고", "여자" 같은 말에 결과가 0으로 나왔다. 조사 세션(하급코더)이 원인을 찾았는데, 검색인지 거르는 noul 질문이 문제였다. "개"나 "맥주"처럼 한 낱말이면 검색으로 보는 확률이 0.2~0.3밖에 안 나와서, 맞는 정거장이 있어도 통째로 걸러지고 있었다.
그래서 몇 가지를 같이 고쳤다. 어떤 정거장이 1.8 이상으로 강하게 맞으면 거르는 질문이 낮아도 통과시키고, 정거장 요약에 사진 캡션(이미 화면에 나가는 공개 글)의 영어 요약을 더하고, 넓은 말에는 동의어를 붙이고, 맞는 정거장이 없으면 가까운 주제를 대신 보여 주게 했다. 캡션을 요약에 넣는 건 내가 허락했다.
버린 방법도 있다. "개"를 animal로 바꿔 묻게 하는 식의 구체적인 동의어는 동물 정거장 12곳 중 개가 있는 곳이 4곳뿐이라 정확도가 나빴다. 문턱만 낮추는 건 걸러야 할 말과 통과시켜야 할 말이 0.21~0.23에서 붙어 있어서 위태로웠다.
그래도 놓치는 게 많았다. 다시 조사해 보니 정거장 질문이 "이 정거장이 찾는 것과 얼마나 맞나"를 물어서, 사진 30장 중 1장만 맞는 정거장은 1점대로 밀려나고 있었다. 정거장 전체가 아니라 "이 정거장의 사진 중 하나라도 그걸 보여 주나"를 묻게 바꿨다.
하급코더 세션 측정. 바꾼 뒤는 약 80%, 정확도 95–100%.
같은 말로 다시 찾아보니 맥주는 2곳에서 10곳, 국수는 0곳에서 8곳, 개는 5곳에서 12곳이 됐다. 대가도 있었다. "시장의 아침"처럼 넓은 말에서는 "아침"이 약해졌다.
"사진을 찾고 그 사진의 정거장을 보여주는게 맞지 않나"
여기까지 보고 이렇게 물었다. "그러면 로직이 잘못된거 아니야? 사진을 찾고 그 사진의 정거장을 보여주는게 맞지 않나? 그러면 너무 입력이 커지나?" 사진을 찾는 게 목적인데 정거장을 먼저 찾는 게 거꾸로 같았다.
조사 세션이 두 길을 알아봤다. 하나는 임베딩인데, TypeSafe에는 임베딩 기능이 없고, 로컬에서 오픈 모델 두 개(e5-small, bge-m3)를 돌려 보니 "밤기차"처럼 뜻으로 찾는 말에 약했다. 다른 하나는 Jev로 사진 1,947장을 전부 판정하는 것이었는데, 재현율은 90%까지 올랐지만 잘못 걸리는 사진이 많았고, 비용이 두 배였고, 초당 요청 한도에 걸릴 위험이 있었다. 둘 다 버리고 정거장을 먼저 찾는 지금 방식을 유지했다.
대신 사진첩을 열 때 한 번 더 묻게 했다. 답으로 나온 정거장들의 사진을 캡션으로 하나씩 noul로 물어서, 맞는 사진만 켜고 나머지는 흐린다. 정확도 89%, 재현율 92%로, 캡션 낱말이 겹치는지로만 고른 것(88%, 82%)보다 나았다. "피라미드"는 두 정거장 61장 중 15장, "밤기차"는 211장 중 8장을 0.45초 만에 골랐다.
"0.2도 비싼거아니야?"
검색 한 번에 입력이 4만 8천 토큰쯤 됐고, 비용은 0.002달러 정도였다. 그걸 보고 한 말이 "와 0.2도 비싼거아니야? 이건 잦은 동작기능인데?"였다. 지구본을 돌리다가 수시로 쓰는 기능이라 한 번에 얼마인지보다 얼마나 자주 부르는지가 문제였다.
그래서 네 가지를 했다. 검색을 GET으로 바꿔 같은 말의 답을 엣지에 일주일 캐시하고, 화면에 보여 주는 예시 다섯 개의 답은 미리 구워 두고, 하루 상한을 인스턴스당 100번으로 내리고, 정거장 요약에서 이야기와 겹치는 캡션이나 거의 같은 캡션을 걷어 냈다. 요약을 줄이고 나서 입력은 약 4만 800토큰, 검색 한 번에 약 0.0017달러가 됐다. 프로덕션에서 같은 말을 두 번 찾으면 두 번째는 엣지 캐시에서 바로 나온다.
로컬에서는 됐는데
프로덕션에서 이 API가 두 번 500으로 죽었다.
처음은 10월 2일 밤, 처음 올렸을 때였다. 함수가 JSON 파일을 import하면서 import attribute를 빠뜨렸는데, Vercel의 Node ESM에서는 이게 로드 단계에서 실패한다. 개발 중에는 vite 개발 서버 플러그인으로만 API를 시험해서 몰랐다.
두 번째는 다음 날 오후, 비용을 줄이는 커밋을 올린 뒤였다. 함수가 ../src/lib/queryText.ts를 import하고 있었다. 내 Mac의 Node 26은 .ts의 타입을 스스로 벗겨 내고 실행해서 테스트가 다 통과했는데, Vercel 산출물에는 그 파일이 .ts로 그대로 남아 있었다. 그 뒤로 함수는 JSON 말고는 import하지 않게 하고, 빌드 산출물을 타입 벗기기를 끈 Node로 직접 불러 보는 테스트를 더했다.
없음과 오류를 어떻게 가르나
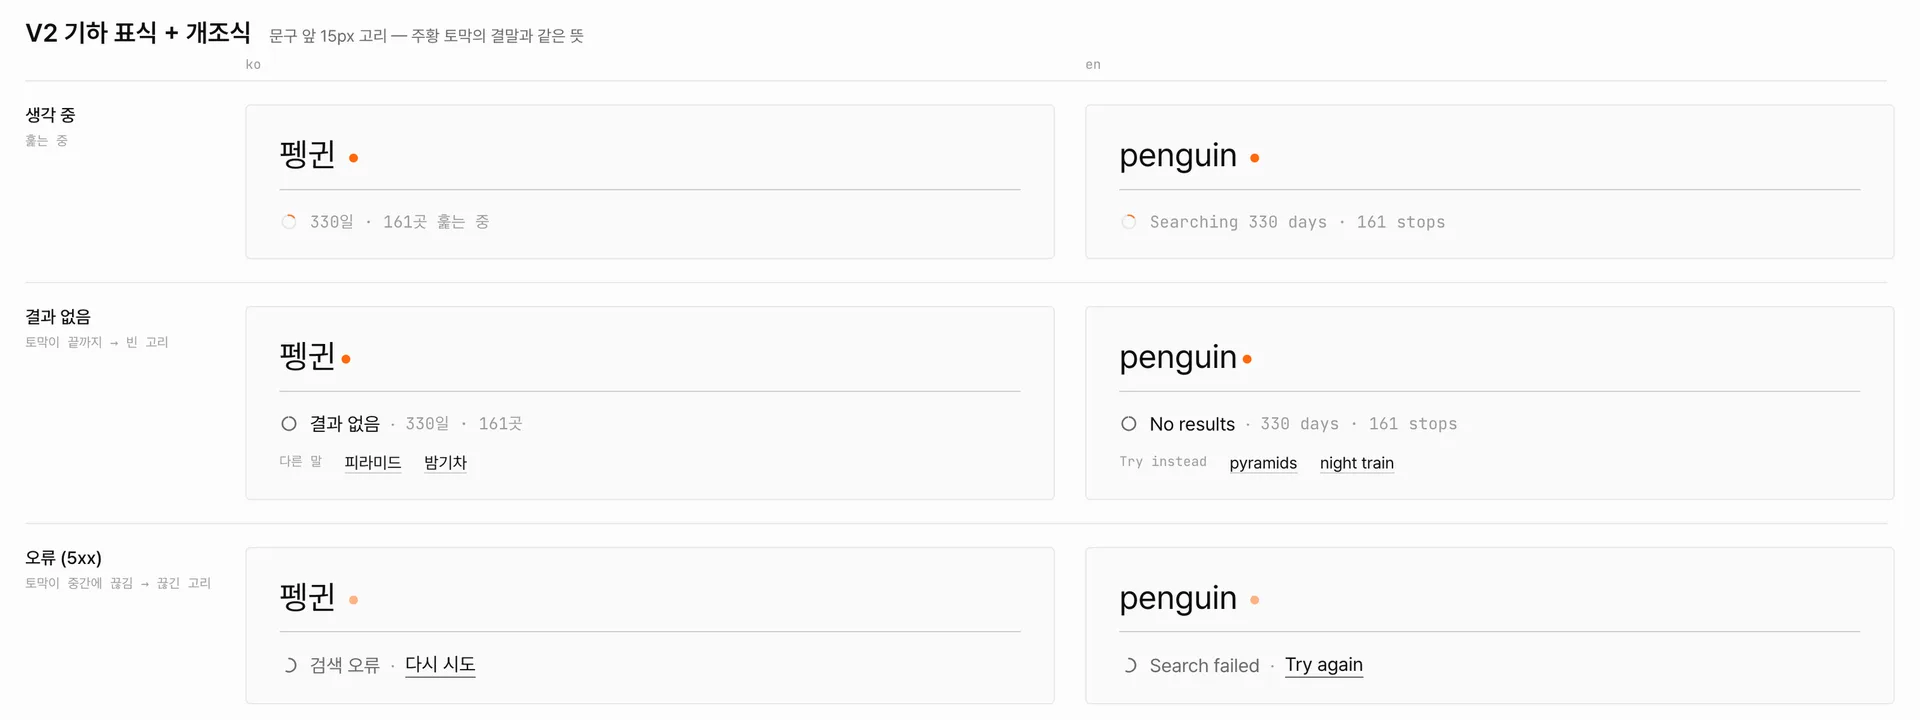
결과가 0인 화면도 문제였다. "이게 아무것도 안나오고 튕기면, 이게 버그인지 아닌지 구분이 안되네." 결과가 없는 것과 검색이 실패한 것이 똑같이 보였다.
처음에는 "~다"로 끝나는 안내 문장이 왔는데 "이게 이상해.. 그냥 개조식으로 가던지... 아니면 아이콘이랑 같이 보여주던지"라고 했다. 그래서 문구 앞에 작은 고리를 하나 두고 상태마다 모양을 바꿨다. 다 그린 빈 고리는 결과 없음, 중간에 끊긴 고리는 오류, 점선 고리는 오프라인이다.
"사원"은 "직원"으로 읽는다
아직 못 찾는 말이 있다. "여자"나 "사원"은 캡션에도 거의 안 나와서 0곳이다. 가까운 주제인 사람으로 받게 해 뒀다. "사원"은 Jev가 절이 아니라 회사의 직원으로 읽는다. 앞 편에 쓴 대로 한국어는 영어만큼 잘하지 않는다고 문서에 적혀 있는데, 이런 낱말이 그 경우인 것 같다. 사용자가 친 말을 한 번 영어로 옮겨서 물으면 나아지는지 보면 알 수 있을 것 같다.
입력 한도도 걸린다. Jev는 요청 하나에 6만 4천 토큰까지 받는데, 시험해 보니 5만 토큰은 통과하고 6만 7천은 거절됐다. 지금 요약이 약 4만 1천이라 여유가 2만 3천쯤이다. 캡션이 많이 늘면 정거장을 나눠서 두 번 불러야 한다. 하루 상한 100번도 Vercel 인스턴스마다 메모리에 세는 것이라 전체 합계가 아니다. 실제로 얼마나 불리는지는 TypeSafe 콘솔의 사용량을 한 달쯤 보면 알 수 있을 것 같다.
끝